1.5 缓存预取与向量化
缓存控制指令概述
现代处理器(SSE及后续指令集)提供特定指令用于直接操作数据缓存,可通过内联函数访问,注意优先做数据缓存布局优化,其次再考虑这个方向的优化
| 功能 | 汇编指令 | 内联函数 | 指令集 |
|---|---|---|---|
| 预取(T0/T1/T2/NTA) | PREFETCHT0 等 | _mm_prefetch(p, hint),hint 见下表 |
SSE |
| 4 字节非临时存 | MOVNTI | _mm_stream_si32 |
SSE2 |
| 8 字节非临时存 | MOVNTI | _mm_stream_si64 |
SSE |
| 16 字节非临时存 float | MOVNTPS | _mm_stream_ps |
SSE |
| 16 字节非临时存 double | MOVNTPD | _mm_stream_pd |
SSE2 |
| 16 字节非临时存整数 | MOVNTDQ | _mm_stream_si128 |
SSE2 |
| 256 位非临时存 float×8 | VMOVNTPS | _mm256_stream_ps |
AVX |
| 256 位非临时存 double×4 | VMOVNTPD | _mm256_stream_pd |
AVX |
| 256 位非临时存 32B 整数 | VMOVNTDQ | _mm256_stream_si256 |
AVX |
| 512 位非临时存 float×16 | VMOVNTPS | _mm512_stream_ps |
AVX-512F |
| 512 位非临时存 double×8 | VMOVNTPD | _mm512_stream_pd |
AVX-512F |
| 512 位非临时存 64B 整数 | VMOVNTDQ | _mm512_stream_si512 |
AVX-512F |
_mm_prefetch 的 hint 常量(与 Intel Intrinsics Guide 一致):
| 宏 | 典型指令 | 含义(摘要) |
|---|---|---|
_MM_HINT_T0 |
PREFETCHT0 | 预取到含 L1 的缓存层次 |
_MM_HINT_T1 |
PREFETCHT1 | 预取到 L2 及更外层 |
_MM_HINT_T2 |
PREFETCHT2 | 预取到 L3 及更外层 |
_MM_HINT_NTA |
PREFETCHNTA | 非时间性预取,减少缓存污染 |
官方参考:Intel Intrinsics Guide;指令语义详见 Intel SDM Volume 2。
预取指令 (Prefetch)
- 提前获取预计后续会使用的缓存行
- 在大多数测试中不提升性能
- 现代处理器通过乱序执行和预测机制已实现自动预取
- 当数据访问模式具有固定步长和规则结构时,一般无需手动预取
非临时写入 (Nontemporal Writes)
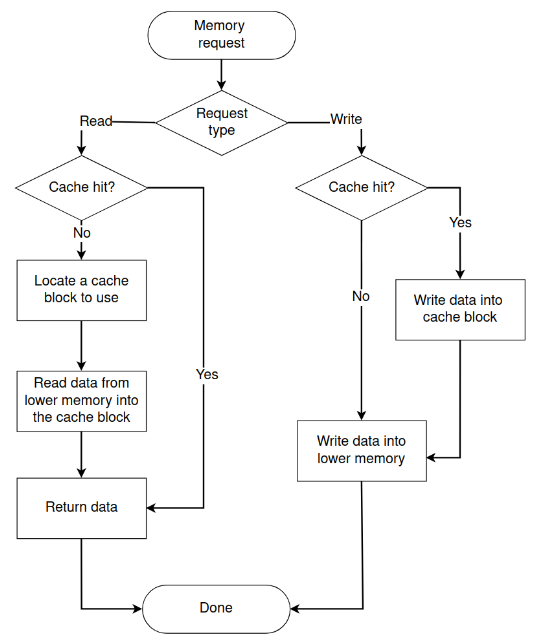
- 解决写入操作缓存未命中的高开销问题
- 直接写入内存,不加载缓存行
- 适用场景:写入后不会很快重新读取同一数据
- 同一内存区域不应混合普通读写与非临时写入
- 当需要对同一地址读写时(如原地修改),非临时写入无效
结论
- 非临时写入仅在可能发生L2缓存未命中时才有优势
- L1缓存未命中对性能影响小,因为不会阻塞后续指令
- L2缓存未命中会导致内存总线饱和,显著影响性能
- 如果能通过其他方式避免缓存争用,非临时写入可能不是最佳选择
使用限制
- 处理器必须支持相应的SSE/SSE2指令集
- 16字节操作指令(MOVNTPS/MOVNTPD/MOVNTDQ)需要操作系统支持XMM寄存器
- 许多非临时存储指令要求内存地址16字节对齐
- 通常仅对回写(Write-back)内存区域有效
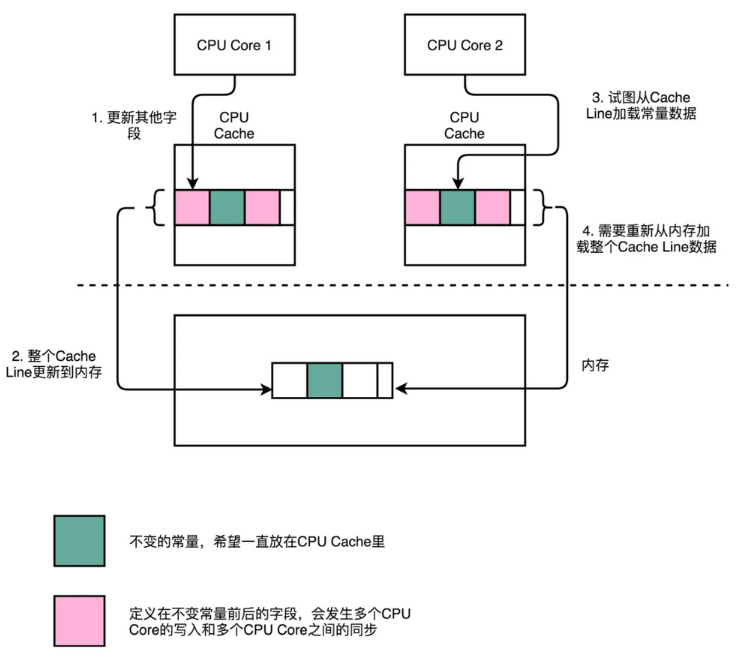
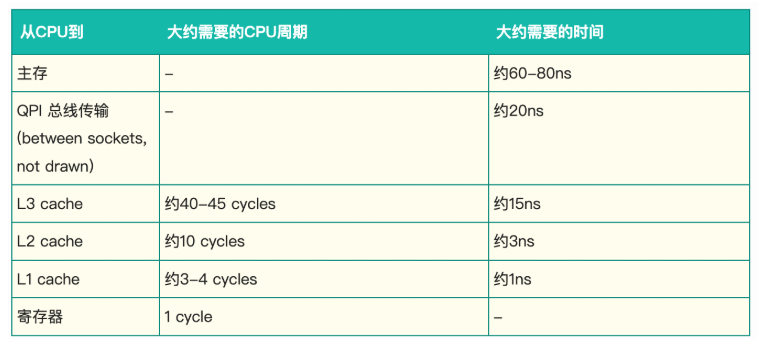
缓存预取是一种硬件或软件技术,它在数据被CPU正式请求之前,就提前将其从较慢的主内存加载到较快的CPU缓存中。其核心思想是预测程序未来可能需要的数据,并提前将其搬运到离计算核心更近的地方,从而掩盖(hide)内存访问的延迟(latency),避免CPU因等待数据而空闲。
软件预取主要通过两种方式实现:内建函数(Intrinsics) 和 编译器指令(Compiler Directives/Pragmas)。
GCC / Clang
- 内建函数 (Built-in Function):
__builtin_prefetch
- `addr`: 要预取的数据的内存地址。

- `rw` (读写):

 * `0` (默认): 为读取(Read)操作进行预取。

 * `1`: 为写入(Write)操作进行预取。这意味着我们很快要向这个地址写入数据,CPU需要提前获取该缓存行的独占(Exclusive)所有权。

- `locality` (时间局部性):

 * `3` (默认): **高时间局部性 (High temporal locality)**。数据加载后,预计会在短时间内被多次使用。这会把数据加载到离CPU核心最近的缓存中(如L1缓存)。

 * `2`: **中等时间局部性**。

 * `1`: **低时间局部性**。数据加载后,预计只会被使用一次或几次。这通常会将数据加载到较远的缓存中(如L2或L3缓存),避免污染L1缓存。

 * `0`: **无时间局部性 (No temporal locality)**。数据加载后,预计在近期不会再被使用。这会使用一种特殊的“非时间性”(Non-Temporal)加载方式,数据在使用后会很快被从缓存中移除,避免污染整个缓存层次结构。这对于需要一次性读写大量数据的流式操作(如视频编码、内存拷贝)非常有用。
#define PREFETCH_DISTANCE 8  // 预取未来8个元素

void process_array(int* data, int n) {
  for (int i = 0; i < n; i++) {
    // 在处理当前元素 data[i] 之前,预取未来的元素 data[i + PREFETCH_DISTANCE]
    if (i + PREFETCH_DISTANCE < n) {
      __builtin_prefetch(&data[i + PREFETCH_DISTANCE], 0, 3);
    }

    // ... 对 data[i] 进行复杂的计算 ...
    data[i] = data[i] * 2 + 1;
  }
}
这里的关键是选择合适的 PREFETCH_DISTANCE。这个距离需要足够大,以保证在CPU处理当前 i 到 i+PREFETCH_DISTANCE 之间的元素时,内存预取操作有足够的时间完成。
Intel C++ Compiler (ICL/ICX)
Intel编译器同样支持 __builtin_prefetch,并且提供了自己的一套内建函数,与x86架构的预取指令直接对应。
- 内建函数 (Intrinsics): 需要包含
<x86intrin.h>或<immintrin.h>头文件。 _mm_prefetch(char const* p, int hint)
hint 参数直接对应处理器的预取指令:
- `_MM_HINT_T0`: 预取到所有级别的缓存(通常指L1)。对应 `PREFETCHT0` 指令。等价于 `__builtin_prefetch` 的 locality `3`。

- `_MM_HINT_T1`: 预取到L2缓存及以上。对应 `PREFETCHT1` 指令。

- `_MM_HINT_T2`: 预取到L3缓存及以上(如果存在)。对应 `PREFETCHT2` 指令。

- `_MM_HINT_NTA`: **Non-Temporal Aligned**。非时间性预取,加载到缓存中并最小化缓存污染。对应 `PREFETCHNTA` 指令。等价于 `__builtin_prefetch` 的 locality `0`。
- 编译器指令 (Pragma/Directive):
这个指令告诉编译器在循环中自动为指定的变量生成预取指令。
void process_array_pragma(int* data, int n) {
#pragma prefetch data : 0 : 8  // 预取data数组,使用T0提示,距离为8
  for (int i = 0; i < n; i++) {
    data[i] = data[i] * 2 + 1;
  }
}
常见缓存预取技术
| Technique | Line of Attack | Lookahead | Accuracy | Cost/Complexity |
|---|---|---|---|---|
| Stride/Stream | 通过程序计数器(PC)或内存地址预测缓存未命中的步长(如数组顺序遍历) | 预测“几个缓存块” | 规则步长访问准确率高(模式固定) | 硬件开销极小(<1 KB) |
| Simple address correlating | 将一个地址关联到多个不同缓存未命中地址(如A→{B,C}) | 仅预测“单个缓存块” | >30%(关联关系弱,易受干扰) | 硬件开销极大(MB级) |
| Linked-data correlating | 自定义有限状态机(FSM),利用循环中“负载到使用依赖”预测指针(如链表遍历) | 预测“几个缓存块” | 对特定数据结构(链表/树)准确率高 | 硬件开销极小(<1 KB) |
| Dead-block correlating | 关联“最多两个地址+控制流”到后续地址(“death event”指缓存块失效事件) | 预测“从失效事件到替换的时间窗口” | >50%(地址+控制流关联较强) | 硬件开销极大(MB级) |
| Temporal streaming | 将一个或多个地址关联到“一系列缓存未命中流”(关注时间维度连续访问) | 预测“多个缓存块” | >50%(时间流连续性带来可预测性) | 片外实现(Off chip) |
| Chained streaming | 通过控制流或层次化地址预测将多个地址流链接(如不同分支流合并) | 预测“多个缓存块” | >50%(控制流增强连接性) | 片外实现(Off chip) |
| Irregular stream buffer | 添加地址间接层,将时间相关性转化为空间相关性(缓冲连续时间访问地址) | 预测“多个缓存块” | >50%(缓冲平滑不规则访问) | 中等(<32 KB) |
| Delta correlation | 记录并关联缓存未命中地址间的Delta序列(如A→A+Δ1→A+Δ1+Δ2) | 预测“几个缓存块” | >30%(Δ序列规律性弱) | 中等(<32 KB) |
| Spatial streaming | 将程序计数器(PC)与缓存未命中地址Delta序列关联(如循环中多数组访问) | 预测“几个缓存块” | >50%(PC与Delta关联增强预测性) | 较高(<64 KB) |
| Execution based | 用辅助线程或推测执行支持并行加载数据(如主线程执行时辅助线程预取) | 受“执行带宽”限制 | 可变(取决于执行资源) | 未提供(依赖执行资源) |
1. Stride/Stream(步长/流技术)
解决思路:通过程序计数器(PC,标识指令位置)或内存地址,预测缓存未命中的“步长”(如数组顺序遍历时,每次访问地址增加固定值)。
前瞻能力:能预测“几个缓存块”(提前量适中,对应步长访问的后续数据)。
准确率:对规则步长访问(如顺序遍历数组)准确率很高(因为模式固定易预测)。
成本/复杂度:硬件开销极小(<1 KB),实现简单(只需少量状态机或计数器)。
适用场景:规则、周期性访问(如密集数组计算)。
2. Simple address correlating(简单地址关联)
解决思路:将一个内存地址关联到“一个或多个不同的缓存未命中地址”(比如若访问A地址后大概率访问B、C地址,建立A→{B,C}的映射)。
前瞻能力:仅能预测“单个缓存块”(关联关系简单,预测范围小)。
准确率:>30%(地址关联关系较弱,易受干扰,准确率偏低)。
成本/复杂度:硬件开销极大(MB 级),需存储大量地址映射关系,复杂度高。
适用场景:简单的一对多地址关联,但实际场景泛化性差。
3. Linked-data correlating(链接数据关联)
解决思路:自定义有限状态机(FSM),利用循环中“负载到使用(Load-to-Use)依赖”(如链表遍历:当前节点的“指针字段”决定下一个访问节点),预测后续指针访问。
前瞻能力:能预测“几个缓存块”(对应链式数据结构的后续几个节点)。
准确率:对特定数据结构(如链表、树)准确率很高(因为依赖关系明确)。
成本/复杂度:硬件开销极小(<1 KB),FSM 结构简单。
适用场景:链式数据结构(如链表遍历、树遍历)。
4. Dead-block correlating(死块关联)
解决思路:关联“最多两个地址 + 控制流”到后续地址(“death event”指缓存块“失效”事件,如块被替换后,预测后续可能再次访问)。
前瞻能力:预测“从失效事件到替换的时间窗口”(关注缓存块生命周期,而非具体地址序列)。
准确率:>50%(地址+控制流的关联比单纯地址关联强,但模式仍较弱)。
成本/复杂度:硬件开销极大(MB 级),需记录地址、控制流、时间窗口等信息。
适用场景:缓存块“失效-复用”模式明显的访问(如局部性较强的重复访问)。
5. Temporal streaming(时间流)
解决思路:将“一个或多个地址”关联到“一系列缓存未命中流”(关注时间维度的连续访问,如视频帧序列、日志流等连续数据)。
前瞻能力:预测“多个缓存块”(覆盖时间流中的连续访问块)。
准确率:>50%(时间流的连续性带来一定可预测性)。
成本/复杂度:片外实现(Off chip)(如用外部存储或逻辑记录流信息,硬件开销在芯片外)。
适用场景:时间连续性强的流式数据(如媒体流、日志采集)。
6. Chained streaming(链式流)
解决思路:用控制流或层次地址预测将“多个地址流”连接起来(比如不同分支下的流合并为一个长流)。
前瞻能力:预测“多个缓存块”(覆盖多流连接后的连续块)。
准确率:>50%(控制流引导流的连接,增强预测性)。
成本/复杂度:片外实现(Off chip)(和 Temporal 类似,需片外逻辑处理多流连接)。
适用场景:多分支控制流下的连续流式访问(如条件分支嵌套的流处理)。
7. Irregular stream buffer(不规则流缓冲)
解决思路:增加“地址间接层”,将时间关联转化为空间关联(比如把“连续时间访问的地址”暂存在缓冲区,再批量转换为空间上的缓存块集合预取)。
前瞻能力:预测“多个缓存块”(缓冲后输出的空间块集合)。
准确率:>50%(通过缓冲“平滑”不规则访问,提升空间局部性)。
成本/复杂度:中等(<32 KB),需片内缓冲区存储中间地址。
适用场景:无明显规则但存在“隐含空间局部性”的不规则访问(如稀疏矩阵计算)。
8. Delta correlation(Delta 相关)
解决思路:记录并关联“缓存未命中地址之间的 Delta(地址差值)序列”(比如访问地址序列是 A, A+Δ1, A+Δ1+Δ2,…,通过 Δ 序列预测后续地址)。
前瞻能力:预测“几个缓存块”(基于 Δ 序列推导后续地址)。
准确率:>30%(Δ 序列的规律性较弱,易受随机访问干扰)。
成本/复杂度:中等(<32 KB),需存储 Δ 序列历史。
适用场景:地址差值存在隐含规律的访问(如某些扫描类算法)。
9. Spatial streaming(空间流)
解决思路:将程序计数器(PC)与“任意缓存未命中地址的 Delta 序列”关联(比如同一 PC 触发的空间相关访问,如循环迭代中对不同数组元素的访问,PC 相同但地址 Delta 序列有规律)。
前瞻能力:预测“几个缓存块”(对应空间流中的连续块)。
准确率:>50%(PC 与空间 Delta 的关联增强预测性)。
成本/复杂度:较高(<64 KB),需存储 PC 与 Delta 序列的映射关系。
适用场景:同一指令触发的空间局部性访问(如向量化计算、多数组并行访问)。
10. Execution based(执行基线)
解决思路:用“辅助线程”或“推测执行支持”,通过并行执行提前加载数据(比如主线程执行时,辅助线程预猜后续访问数据并加载;或硬件推测执行路径,提前拉取数据)。
前瞻能力:受“执行带宽”限制(能并行执行多少指令/线程,就决定预测范围)。
准确率:可变(varies),取决于执行资源(如线程数、推测正确率)。
成本/复杂度:未提供(--),但实现高度依赖执行资源(如多核、推测执行逻辑),成本和复杂度因设计而异。
适用场景:可并行化或存在推测路径的计算(如任务级并行、条件分支推测)。
示例:
#pragma once

#include <cstdint>

#if defined(__SSE2__) || defined(_MSC_VER)
#include <immintrin.h>
#elif defined(__aarch64__)
#include <arm_neon.h>
#endif

/**
 * @brief Defines the target cache level for prefetching.
 * The values are chosen to align with GCC/Clang's __builtin_prefetch locality
 * hints.
 */
enum class PrefetchLevel {
  L1 = 3,  // Hint for high temporal locality (L1 cache)
  L2 = 2,  // Hint for moderate temporal locality (L2 cache)
  L3 = 1   // Hint for low temporal locality (L3 cache)
};

/**
 * @brief Issues a prefetch hint for a given memory address and cache level.
 *
 * This function abstracts the platform-specific prefetch intrinsics.
 *
 * @param address A pointer to the memory address to prefetch.
 * @param level The target cache level (L1, L2, or L3).
 */
inline void prefetch(const void* address, PrefetchLevel level) {
#if defined(__SSE2__) || defined(_MSC_VER)
  int hint;
  switch (level) {
    case PrefetchLevel::L1:
      hint = _MM_HINT_T0;
      break;
    case PrefetchLevel::L2:
      hint = _MM_HINT_T1;
      break;
    case PrefetchLevel::L3:
      hint = _MM_HINT_T2;
      break;
  }
  _mm_prefetch(static_cast<const char*>(address), hint);
#elif defined(__GNUC__) || defined(__clang__)
  __builtin_prefetch(address, 0, static_cast<int>(level));
#endif
}

/**
 * @brief Prefetches data to L1 cache.
 * @param address A pointer to the memory address to prefetch.
 */
inline void prefetch_l1(const void* address) {
  prefetch(address, PrefetchLevel::L1);
}

/**
 * @brief Prefetches data to L2 cache.
 * @param address A pointer to the memory address to prefetch.
 */
inline void prefetch_l2(const void* address) {
  prefetch(address, PrefetchLevel::L2);
}

/**
 * @brief Prefetches data to L3 cache.
 * @param address A pointer to the memory address to prefetch.
 */
inline void prefetch_l3(const void* address) {
  prefetch(address, PrefetchLevel::L3);
}

/**
 * @brief Prefetches a block of data to L1 cache.
 * @param address A pointer to the starting memory address.
 * @param lines The number of 64-byte cache lines to prefetch.
 */
inline void mem_prefetch_l1(void* address, uint32_t lines) {
  for (uint32_t i = 0; i < lines; ++i) {
    prefetch_l1(static_cast<char*>(address) + i * 64);
  }
}

/**
 * @brief Prefetches a block of data to L2 cache.
 * @param address A pointer to the starting memory address.
 * @param lines The number of 64-byte cache lines to prefetch.
 */
inline void mem_prefetch_l2(void* address, uint32_t lines) {
  for (uint32_t i = 0; i < lines; ++i) {
    prefetch_l2(static_cast<char*>(address) + i * 64);
  }
}

/**
 * @brief Prefetches a block of data to L3 cache.
 * @param address A pointer to the starting memory address.
 * @param lines The number of 64-byte cache lines to prefetch.
 */
inline void mem_prefetch_l3(void* address, uint32_t lines) {
  for (uint32_t i = 0; i < lines; ++i) {
    prefetch_l3(static_cast<char*>(address) + i * 64);
  }
}
#include <cstdint>
#include <iostream>
#include <vector>

#include "prefetch.h"

// 模拟一个数据结构,其大小约为一个缓存行
struct DataPacket {
  uint64_t id;
  double data[7];
};

int main() {
  // --- 准备一些示例数据 ---
  const size_t data_size = 1024;
  std::vector<DataPacket> data_array(data_size);
  for (size_t i = 0; i < data_size; ++i) {
    data_array[i].id = i;
  }

  std::cout << "--- 预取接口使用示例 ---" << std::endl;

  // --- 1. 直接使用通用的 prefetch() 函数 ---
  if (data_size > 10) {
    // 使用通用的 prefetch 函数,预取第10个元素到L1缓存。
    std::cout << "Directly prefetching element 10 to L1 cache." << std::endl;
    prefetch(&data_array[10], PrefetchLevel::L1);

    // 使用通用的 prefetch 函数,预取第11个元素到L2缓存。
    std::cout << "Directly prefetching element 11 to L2 cache." << std::endl;
    prefetch(&data_array[11], PrefetchLevel::L2);

    // 使用通用的 prefetch 函数,预取第12个元素到L3缓存。
    std::cout << "Directly prefetching element 12 to L3 cache." << std::endl;
    prefetch(&data_array[12], PrefetchLevel::L3);
  }
  std::cout << std::endl;

  // --- 2. 使用便捷的 prefetch_l*() 辅助函数 ---
  if (data_size > 20) {
    // 使用辅助函数 prefetch_l1,这是预取到L1缓存的快捷方式。
    std::cout << "Using helper to prefetch element 20 to L1 cache."
              << std::endl;
    prefetch_l1(&data_array[20]);

    // 使用辅助函数 prefetch_l2,预取到L2缓存。
    std::cout << "Using helper to prefetch element 21 to L2 cache."
              << std::endl;
    prefetch_l2(&data_array[21]);

    // 使用辅助函数 prefetch_l3,预取到L3缓存。
    std::cout << "Using helper to prefetch element 22 to L3 cache."
              << std::endl;
    prefetch_l3(&data_array[22]);
  }
  std::cout << std::endl;

  // --- 3. 使用块预取 mem_prefetch_l*() 函数 ---
  if (data_size > 100) {
    // 使用 mem_prefetch_l1 预取一个数据块(4个缓存行)到L1缓存。
    // 这对于即将要处理的连续数据非常有用。
    std::cout << "Prefetching a block of 4 cache lines to L1 cache starting "
                 "from element 100."
              << std::endl;
    mem_prefetch_l1(&data_array[100], 4);

    // 使用 mem_prefetch_l2 预取另一个数据块到L2缓存。
    std::cout << "Prefetching a block of 8 cache lines to L2 cache starting "
                 "from element 200."
              << std::endl;
    mem_prefetch_l2(&data_array[200], 8);

    // 使用 mem_prefetch_l3 预取第三个数据块到L3缓存。
    std::cout << "Prefetching a block of 2 cache lines to L3 cache starting "
                 "from element 300."
              << std::endl;
    mem_prefetch_l3(&data_array[300], 2);
  }
  std::cout << std::endl;

  std::cout << "--- 所有预取接口调用演示完毕 ---" << std::endl;

  // 在实际应用中,接下来会是对 data_array 的密集计算循环

  return 0;
}
缓存预取在多阶段流水线式任务的优化
#ifndef PIPELINE_PREFETCH_HPP
#define PIPELINE_PREFETCH_HPP

#include <cstddef>
#include <cstdint>
#include <cstring>
#include <functional>
#include <memory>
#include <vector>

enum class PipelineError {
  SUCCESS = 0,
  INVALID_ARGUMENT,
  OUT_OF_MEMORY,
  BUFFER_OVERFLOW,
  INVALID_STATE
};

// 预取策略枚举
enum class PrefetchStrategy {
  NONE = 0,
  READ_NEAR,
  READ_FAR,
  WRITE_NEAR,
  WRITE_FAR
};

template <typename T>
constexpr size_t get_cache_line_size() {
  return std::hardware_destructive_interference_size;
}

template <size_t N>
constexpr size_t calculate_prefetch_distance() {
  return (N > 8) ? N / 4 : 2;
}

template <PrefetchStrategy Strategy>
inline void prefetch_impl(const void* ptr) {
  if constexpr (Strategy == PrefetchStrategy::READ_NEAR) {
    __builtin_prefetch(ptr, 0, 3);  // 读取,高时间局部性
  } else if constexpr (Strategy == PrefetchStrategy::READ_FAR) {
    __builtin_prefetch(ptr, 0, 0);  // 读取,低时间局部性
  } else if constexpr (Strategy == PrefetchStrategy::WRITE_NEAR) {
    __builtin_prefetch(ptr, 1, 3);  // 写入,高时间局部性
  } else if constexpr (Strategy == PrefetchStrategy::WRITE_FAR) {
    __builtin_prefetch(ptr, 1, 0);  // 写入,低时间局部性
  }
}

// 流水线阶段状态
enum class StageState { IDLE = 0, PROCESSING, COMPLETED, ERROR };

// 阶段函数
using GenericStageFunction = std::function<PipelineError(
    void* input, void* output, size_t count, size_t element_size)>;

// 多阶段流水线处理器
class MultiStagePipeline {
 public:
  // 构造函数
  MultiStagePipeline(void* input_buffer, void* output_buffer,
                     size_t buffer_size)
      : input_buffer_(input_buffer),
        output_buffer_(output_buffer),
        buffer_size_(buffer_size) {
    if (!input_buffer || !output_buffer || buffer_size == 0) {
      error_code_ = PipelineError::INVALID_ARGUMENT;
    } else {
      error_code_ = PipelineError::SUCCESS;
    }
  }

  // 获取构造错误码
  PipelineError get_construct_error() const { return error_code_; }

  // 添加处理阶段
  template <typename InputType, typename OutputType>
  void add_stage(std::function<PipelineError(InputType* input,
                                             OutputType* output, size_t count)>
                     stage_func) {
    GenericStageFunction func = [stage_func](
                                    void* input, void* output, size_t count,
                                    size_t element_size) -> PipelineError {
      // 验证元素大小是否匹配
      if (element_size != sizeof(InputType)) {
        return PipelineError::INVALID_ARGUMENT;
      }

      return stage_func(static_cast<InputType*>(input),
                        static_cast<OutputType*>(output), count);
    };

    stage_functions_.push_back(func);
    stage_input_sizes_.push_back(sizeof(InputType));
    stage_output_sizes_.push_back(sizeof(OutputType));
    stage_states_.push_back(StageState::IDLE);
  }

  // 设置输入数据
  template <typename InputType>
  PipelineError set_input(const InputType* data, size_t count) {
    if (!data || count == 0 || count > buffer_size_) {
      return PipelineError::INVALID_ARGUMENT;
    }

    // 验证缓冲区是否有效
    if (!input_buffer_) {
      return PipelineError::INVALID_ARGUMENT;
    }

    // 连续内存拷贝,优化缓存访问
    memcpy(input_buffer_, data, count * sizeof(InputType));

    // 预取输入数据
    for (size_t i = 0; i < count && i < calculate_prefetch_distance<16>();
         ++i) {
      prefetch_impl<PrefetchStrategy::READ_NEAR>(
          static_cast<char*>(input_buffer_) + i * sizeof(InputType));
    }

    input_count_ = count;
    initial_input_size_ = sizeof(InputType);

    return PipelineError::SUCCESS;
  }

  // 执行流水线处理
  PipelineError process() {
    if (input_count_ == 0) {
      return PipelineError::INVALID_ARGUMENT;
    }

    if (stage_functions_.empty()) {
      return PipelineError::INVALID_ARGUMENT;
    }

    void* current_input = input_buffer_;
    void* current_output = output_buffer_;
    size_t current_input_size = initial_input_size_;

    // 多阶段流水线执行
    for (size_t stage_idx = 0; stage_idx < stage_functions_.size();
         ++stage_idx) {
      stage_states_[stage_idx] = StageState::PROCESSING;

      // 预取当前阶段的输出缓冲区
      prefetch_impl<PrefetchStrategy::WRITE_NEAR>(current_output);

      // 执行当前阶段处理
      PipelineError stage_result = stage_functions_[stage_idx](
          current_input, current_output, input_count_, current_input_size);
      if (stage_result != PipelineError::SUCCESS) {
        stage_states_[stage_idx] = StageState::ERROR;
        return stage_result;
      }

      stage_states_[stage_idx] = StageState::COMPLETED;

      // 交换输入输出缓冲区指针,为下一阶段准备
      std::swap(current_input, current_output);
      current_input_size = stage_output_sizes_[stage_idx];
    }

    // 如果阶段数为奇数,最终结果在output_buffer_中
    // 如果阶段数为偶数,最终结果在input_buffer_中
    final_output_ =
        (stage_functions_.size() % 2 == 0) ? input_buffer_ : output_buffer_;

    return PipelineError::SUCCESS;
  }

  // 获取输出结果
  template <typename OutputType>
  PipelineError get_output(OutputType* output, size_t* output_count) {
    if (!output || !output_count) {
      return PipelineError::INVALID_ARGUMENT;
    }

    if (*output_count < input_count_) {
      return PipelineError::BUFFER_OVERFLOW;
    }

    // 验证输出缓冲区是否有效
    if (!final_output_) {
      return PipelineError::INVALID_STATE;
    }

    // 复制输出数据,确保连续内存访问
    memcpy(output, final_output_, input_count_ * sizeof(OutputType));
    *output_count = input_count_;

    return PipelineError::SUCCESS;
  }

  // 获取输出结果指针(直接访问内部缓冲区)
  void* get_output_ptr() const { return final_output_; }

  // 获取阶段数量
  size_t get_stage_count() const { return stage_functions_.size(); }

  // 获取阶段状态
  StageState get_stage_state(size_t stage_index) const {
    if (stage_index >= stage_states_.size()) {
      return StageState::ERROR;
    }
    return stage_states_[stage_index];
  }

  // 获取当前处理的数据量
  size_t get_input_count() const { return input_count_; }

  // 获取缓冲区大小
  size_t get_buffer_size() const { return buffer_size_; }

  // 重置流水线状态
  PipelineError reset() {
    for (auto& state : stage_states_) {
      state = StageState::IDLE;
    }
    input_count_ = 0;
    initial_input_size_ = 0;
    final_output_ = nullptr;
    return PipelineError::SUCCESS;
  }

 private:
  std::vector<GenericStageFunction> stage_functions_;
  std::vector<size_t> stage_input_sizes_;
  std::vector<size_t> stage_output_sizes_;
  std::vector<StageState> stage_states_;

  void* input_buffer_{nullptr};   // 外部传入的输入缓冲区
  void* output_buffer_{nullptr};  // 外部传入的输出缓冲区
  void* final_output_{nullptr};   // 最终结果的缓冲区
  const size_t buffer_size_;
  size_t input_count_{0};
  size_t initial_input_size_{0};
  PipelineError error_code_{PipelineError::SUCCESS};  // 构造错误码
};

// 便捷宏
#define CREATE_EXTERNAL_PIPELINE(input_buf, output_buf, buf_size) \
  MultiStagePipeline(input_buf, output_buf, buf_size)

#endif  // PIPELINE_PREFETCH_HPP
缓存预热(D-cache & I-cache warming)
主动将这些数据从RAM拉进CPU的L1/L2/L3缓存。
- 原理: CPU实际访问(读或写)某块内存时,将那块内存加载到缓存行。
- 实现:
- 编写一个循环,遍历所有在关键路径上会用到的数据结构。
- 在循环中,对每个元素执行一次无害的读操作。为防止编译器优化,使用
volatile关键字。
确保关键代码本身也在CPU缓存里。
- 原理: CPU只有在执行某段代码时,才会将对应的机器指令加载到指令缓存中。
- 实现:
- 在预热阶段,用模拟的数据调用所有核心交易函数。
- 模拟一次完整的交易处理流程,从接收行情、决策分析、风险检查到生成订单,不实际对外发送消息。
- 强制CPU执行关键路径上的所有分支和函数,将它们的机器指令加载到缓存行中。
频繁运行一个假的执行路径把常用数据读出来而驻留缓存
与缓存相关的x86 CPU指令
| 指令类别 | 指令名称 | 功能 | 缓存层级影响 | 持久内存交互 | 适用场景 | 性能影响 |
|---|---|---|---|---|---|---|
| 缓存刷新 | CLFLUSH | 写回并失效缓存行 | L1/L2/L3 | 需配合FENCE保证持久化 | 需确保数据持久化的场景 | 高延迟,高开销,影响后续缓存命中 |
| 缓存刷新 | CLFLUSHOPT | 并行写回并失效缓存行 | L1/L2/L3 | 需配合SFENCE保证顺序 | 批量刷新缓存行的场景 | 中等延迟,低开销,可并发执行 |
| 缓存刷新 | CLWB | 写回缓存行但不使其失效 | L1/L2/L3 | 可直接持久化到持久内存 | 持久内存编程且需保持缓存命中 | 低延迟,低开销,保留缓存内容 |
| 缓存刷新 | INVLPG | 刷新特定虚拟地址的TLB条目 | TLB | 影响地址映射路径 | 修改页表后的TLB刷新 | 高延迟,多核环境需额外同步开销 |
| 内存屏障 | MFENCE | 全内存屏障,确保所有内存操作顺序 | 全局 | 保证持久化顺序 | 需严格保证内存操作顺序的场景 | 高延迟,但确保内存一致性 |
| 内存屏障 | SFENCE | 写屏障,确保写操作顺序 | 全局 | 与非临时存储配合使用 | 非临时存储和WC内存类型场景 | 中等延迟,确保写操作顺序 |
| 内存屏障 | LFENCE | 读屏障,阻止后续读取提前执行 | 全局 | 保证读取顺序 | 需严格顺序读取的场景 | 低延迟,但仅影响读取顺序 |
| 非临时存储 | MOVNTI | 绕过缓存直接写入内存 | 绕过L1/L2缓存 | 需配合SFENCE保证持久化 | 大数据量传输和流式写入 | 避免缓存污染,但需注意内存一致性 |
| 非临时存储 | MOVDIR64B | 直接写入64字节到持久内存 | 完全绕过所有缓存 | 直接持久化到持久内存 | 高带宽持久内存操作 | 最高带宽,但延迟较高,仅Intel支持 |
| 预取指令 | PREFETCHT0 | 预取数据到各级缓存 | L1/L2/L3 | 无 | 已知顺序访问模式的数据 | 提高缓存命中率,但可能污染缓存 |
| 预取指令 | PREFETCHT1 | 预取数据到L2及以上缓存 | L2/L3 | 无 | 中等规模数据预取 | 减少对L1缓存的占用,平衡预取效果 |
| 预取指令 | PREFETCHT2 | 预取数据到L2缓存 | L2 | 无 | 大规模数据预取 | 降低预取带宽,减少对缓存的污染 |
| 预取指令 | PREFETCHNTA | 预取非临时数据到最近缓存 | L1/L2/L3 | 无 | 预取大量非重复使用数据 | 最小化缓存污染,但预取效果有限 |
| 流水线优化 | PAUSE | 优化自旋等待循环性能 | 无 | 无 | 自旋锁和等待条件满足 | 降低功耗,减少CPU资源争用 |
| 同步指令 | MONITOR/MWAIT | 硬件级线程同步 | 无 | 无 | 精确控制线程同步 | 比软件等待机制更高效,减少CPU空转 |
| 系统级控制 | WBINVD | 写回并失效所有缓存 | L1/L2/L3 | 无 | 系统级缓存管理 | 极高延迟,仅操作系统使用 |
| 系统级控制 | INVD | 使所有内部缓存无效 | L1/L2/L3 | 无 | 特殊测试环境 | 高延迟,可能导致数据丢失 |
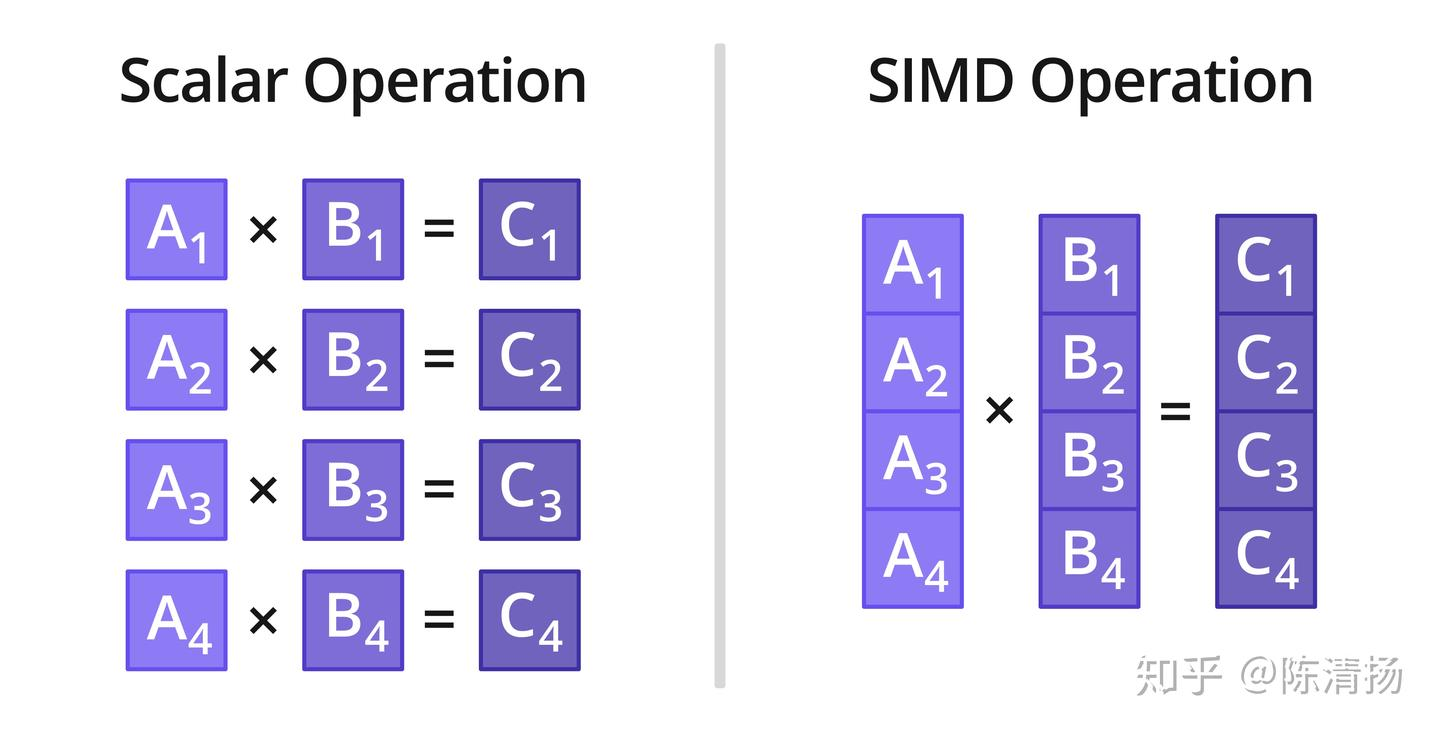
向量化是一种利用CPU中SIMD硬件单元来并行处理多个数据元素的优化技术。现代CPU(如x86架构的SSE, AVX, AVX-512;ARM架构的NEON)都包含SIMD指令集。
对一个数组中的每个元素都加1。
- 标量(Scalar)操作: 传统方式是使用一个循环,每次迭代取一个元素,执行一次加法,再存回去。一次指令只处理一个数据。
- 向量(Vector)操作: 如果CPU有一个256位的SIMD寄存器(如AVX2),它可以一次性装入8个32位的整数。CPU可以执行一条向量加法指令,这条指令能同时对这8个整数执行加法操作。理论上,这能带来最高8倍的性能提升。
不同指令集扩展中可用的向量大小
| 元素类型 | 每个元素大小(位) | 元素数量 | 向量总大小(位) | 指令集 |
|---|---|---|---|---|
| char | 8 | 8 | 64 | MMX |
| short int | 16 | 4 | 64 | MMX |
| int | 32 | 2 | 64 | MMX |
| int64_t | 64 | 1 | 64 | MMX |
| char | 8 | 16 | 128 | SSE2 |
| short int | 16 | 8 | 128 | SSE2 |
| int | 32 | 4 | 128 | SSE2 |
| int64_t | 64 | 2 | 128 | SSE2 |
| _Float16 | 16 | 8 | 128 | AVX512FP16 |
| float | 32 | 4 | 128 | SSE |
| double | 64 | 2 | 128 | SSE2 |
| char | 8 | 32 | 256 | AVX2 |
| short int | 16 | 16 | 256 | AVX2 |
| int | 32 | 8 | 256 | AVX2 |
| int64_t | 64 | 4 | 256 | AVX2 |
| _Float16 | 16 | 16 | 256 | AVX512FP16 |
| float | 32 | 8 | 256 | AVX |
| double | 64 | 4 | 256 | AVX |
| char | 8 | 64 | 512 | AVX512BW |
| short int | 16 | 32 | 512 | AVX512BW |
| int | 32 | 16 | 512 | AVX512F |
| int64_t | 64 | 8 | 512 | AVX512F |
| _Float16 | 16 | 32 | 512 | AVX512FP16 |
| float | 32 | 16 | 512 | AVX512F |
| double | 64 | 8 | 512 | AVX512F |
重要说明:
- 向量操作使用一组特殊的向量寄存器
- 最大寄存器宽度取决于可用的指令集:SSE2为128位(XMM),AVX为256位(YMM),AVX512为512位
- 例如:128位XMM寄存器在SSE2指令集下可组织为8个16位整数或4个float的向量
- 应避免使用64位MMX寄存器,因为它们不能与x87浮点代码混合使用
编译器自动向量化及指令
现代编译器能够自动识别适合向量化的循环和操作
需要满足的条件:
- 循环迭代之间无数据依赖
- 简单的循环结构(无复杂的控制流)
- 连续的内存访问模式
优化技巧:
- 使用对齐的内存分配提高向量化效率
- 避免在循环中使用函数调用(除非是内联函数)
- 使用restrict关键字或__restrict修饰符消除指针别名问题
- 确保数组大小是向量宽度的整数倍
- GCC / Clang:
-O3,-Ofast: 这些高级别优化选项通常会自动开启自动向量化。-ftree-vectorize: 显式开启向量化(在-O3级别默认开启)。-fopt-info-vec或-Rpass=loop-vectorize(Clang): 让编译器输出详细的向量化报告,告诉你哪些循环被向量化了,哪些没有,以及原因。-march=native: 让编译器为当前机器的CPU架构生成最优指令,包括使用最新的SIMD指令集(如AVX2, AVX-512)。-mavx, -mavx2, -mavx512启用特定指令集- Intel C++ Compiler:
-O2,-O3: 默认开启自动向量化。-ax<CODES>or-x<CODES>: 例如-xAVX2会告诉编译器可以使用AVX2指令集。-qopt-reportor-qopt-report-phase=vec: 生成详细的优化报告。
显式向量化指令 (Pragmas)
当编译器因为某些原因(如潜在的指针别名)而不敢向量化时,可以使用pragma来提供更多信息或强制执行。
- 通用 (OpenMP 4.0+标准,被GCC, Clang, ICL支持):
这是目前最推荐、可移植性最好的方式。它向编译器断言,接下来的循环可以被安全地向量化。
void add_arrays(float* a, float* b, float* c, int n) {
#pragma omp simd
  for (int i = 0; i < n; i++) {
    c[i] = a[i] + b[i];
  }
}
- GCC / Clang 特有:
这个指令告诉编译器忽略循环中潜在的向量依赖关系。这是一种比较强的断言,使用时必须确保没有数据依赖会破坏正确性。
- Intel C++ Compiler 特有:
功能与 #pragma omp simd 类似。
功能与 #pragma GCC ivdep 类似。
断言循环中的数据是内存对齐的,有助于编译器生成更高效的对齐加载/存储指令。
AVX 内建函数
Intel Intrinsics Guide(内建函数检索) · Intel SDM(Volume 2)
1.AVX内建函数的定义与优势
AVX内建函数本质是x86/x64 CPU硬件指令的C++封装,通过“单条指令操作多个数据元素”实现并行计算。
| AVX版本 | 寄存器宽度 | 可并行处理32位浮点数数量 | 适用场景 |
|---|---|---|---|
| AVX | 128位 | 4个 | 入门级并行,低资源设备 |
| AVX-2 | 256位 | 8个 | 主流场景,平衡性能与资源 |
| AVX-512 | 512位 | 16个 | 高性能场景(如AI推理、HFT) |
| AVX-10 | 512位 | 16个(含性能优化) | 新一代x86架构高性能计算 |
低延迟(CPU本地执行,无GPU数据传输开销)、开发门槛低于汇编、可与C++代码无缝集成;
2. 核心组件:寄存器类型与头文件
AVX通过特定的C++类型表示寄存器,通过专用头文件声明内建函数,确保编译期类型安全与指令正确生成:
- 寄存器类型:以双下划线
__开头,后缀表示寄存器宽度与数据类型,例如: __m128:128位寄存器,存储4个32位浮点数(float);__m256i:256位寄存器,存储8个32位整数(int);__m512d:512位寄存器,存储8个64位浮点数(double);- 头文件依赖:需包含对应头文件才能使用AVX内建函数,常用头文件包括:
<intrin.h>:通用内建函数声明(适用于MSVS、GCC);<emmintrin.h>:SSE/AVX基础指令(128位操作);<immintrin.h>:AVX-2/AVX-512扩展指令(256/512位操作)。
3.AVX的核心操作:垂直与水平指令
垂直操作:跨向量元素对并行计算
(1)基础垂直操作示例:元素级乘法
- AVX(128位):4个32位浮点数并行乘法
#include <immintrin.h>
// 输入:两个含4个float的数组,输出:元素级乘法结果数组
void aussie_avx_multiply_4_floats(float v1[4], float v2[4], float result[4]) {
  // 1. 加载数组数据到AVX寄存器(_mm_loadu_ps支持非对齐地址)
  __m128 reg1 = _mm_loadu_ps(v1);
  __m128 reg2 = _mm_loadu_ps(v2);
  // 2. 垂直乘法:reg1与reg2的4个元素逐位相乘
  __m128 reg_result = _mm_mul_ps(reg1, reg2);
  // 3. 将寄存器结果存储回数组
  _mm_storeu_ps(result, reg_result);
}
- AVX-2(256位):8个32位浮点数并行乘法
// 输入:两个含8个float的数组,输出:元素级乘法结果数组
void aussie_avx2_multiply_8_floats(float v1[8], float v2[8], float result[8]) {
  __m256 reg1 = _mm256_loadu_ps(v1);  // 256位寄存器加载
  __m256 reg2 = _mm256_loadu_ps(v2);
  __m256 reg_result = _mm256_mul_ps(reg1, reg2);  // AVX-2乘法指令
  _mm256_storeu_ps(result, reg_result);           // 256位寄存器存储
}
- AVX-512(512位):16个32位浮点数并行乘法
// 输入:两个含16个float的数组,输出:元素级乘法结果数组
void aussie_avx512_multiply_16_floats(float v1[16], float v2[16],
                                      float result[16]) {
  __m512 reg1 = _mm512_loadu_ps(v1);  // 512位寄存器加载
  __m512 reg2 = _mm512_loadu_ps(v2);
  __m512 reg_result = _mm512_mul_ps(reg1, reg2);  // AVX-512乘法指令
  _mm512_storeu_ps(result, reg_result);           // 512位寄存器存储
}
指令命名规则:AVX内建函数名遵循“_mm[宽度]_操作_数据类型”格式,例如_mm256_mul_ps中,“256”表示256位寄存器,“mul”表示乘法,“ps”表示“packed single-precision”(打包32位浮点数)。
(2)常用垂直操作指令
| 操作类型 | AVX(128 位) | AVX2(256 位) | AVX-512(512 位) | 功能描述 |
|---|---|---|---|---|
| 初始化 | _mm_setzero_ps |
_mm256_setzero_ps |
_mm512_setzero_ps |
打包 float 置零 |
| 加载(非对齐) | _mm_loadu_ps |
_mm256_loadu_ps |
_mm512_loadu_ps |
从内存加载 |
| 存储(非对齐) | _mm_storeu_ps |
_mm256_storeu_ps |
_mm512_storeu_ps |
存回内存 |
| 加法 | _mm_add_ps |
_mm256_add_ps |
_mm512_add_ps |
元素级加 |
| 乘法 | _mm_mul_ps |
_mm256_mul_ps |
_mm512_mul_ps |
元素级乘 |
| 融合乘加 | _mm_fmadd_ps |
_mm256_fmadd_ps |
_mm512_fmadd_ps |
一条完成乘加(需 CPU 支持 FMA) |
| 点积类 | _mm_dp_ps |
_mm256_dp_ps |
无单一 _mm512_dp_ps;常用 mul + fmadd + reduce / 掩码组合 |
见 Intrinsics Guide |
命名后缀(AVX-512 常见):ps/pd 为打包单/双精度;整数多为 epi32、epu32 等;带谓词写回多为 _mm512_mask_* 形式。
水平操作:单向量内部元素并行计算
AVX/AVX-2与AVX-512的水平操作差异显著:
- AVX/AVX-2: pairwise 水平操作:仅支持“元素对”处理(如将向量分为多个元素对,对每对执行操作),无法直接实现“向量到标量的归约”(如求和所有元素),需多次调用指令并结合“洗牌(shuffle)”操作完成归约。例如,AVX-2的8个浮点数求和需3次
_mm256_hadd_ps(水平加法)与1次_mm256_extractf128_ps(寄存器拆分); - AVX-512:直接归约操作:新增“reduce”系列指令,可直接实现“向量到标量的归约”,无需多次调用。例如,
_mm512_reduce_add_ps可一次性求和16个32位浮点数,大幅简化代码并提升效率:
// AVX-512 16个float求和(直接归约)
float aussie_avx512_reduce_add(float v[16]) {
  __m512 reg = _mm512_loadu_ps(v);
  // 直接求和寄存器内16个float,返回标量结果
  return _mm512_reduce_add_ps(reg);
}
- 常用水平操作指令:
| 操作类型 | AVX-2(256位)指令 | AVX-512(512位)指令 | 功能描述 |
|---|---|---|---|
| 水平加法 | _mm256_hadd_ps |
_mm512_reduce_add_ps |
元素求和(AVX-2需多次调用) |
| 水平最大值 | _mm256_hmax_ps |
_mm512_reduce_max_ps |
找向量内最大值 |
| 水平最小值 | _mm256_hmin_ps |
_mm512_reduce_min_ps |
找向量内最小值 |
5. 内存对齐:提升加载/存储效率
AVX指令对内存地址的“对齐宽度”有明确要求(与寄存器宽度一致),非对齐地址会导致_mm_load_ps等指令报错,或_mm_loadu_ps(支持非对齐)指令性能下降:
- 对齐要求:
| AVX版本 | 寄存器宽度 | 内存对齐要求 | 示例(32位float数组) |
|---|---|---|---|
| AVX | 128位 | 16字节对齐 | alignas(16) float arr[4] |
| AVX-2 | 256位 | 32字节对齐 | alignas(32) float arr[8] |
| AVX-512 | 512位 | 64字节对齐 | alignas(64) float arr[16] |
- 对齐检查:通过位运算快速判断地址是否对齐(替代慢速的
%运算符):
// 检查地址是否16字节对齐
#define IS_ALIGNED_16(ptr) (((unsigned long)(ptr) & 15UL) == 0)
// 检查地址是否32字节对齐
#define IS_ALIGNED_32(ptr) (((unsigned long)(ptr) & 31UL) == 0)
6. CPU兼容性:动态检测与多版本适配
不同CPU对AVX版本的支持差异大(如部分旧Intel CPU不支持AVX-512,部分新CPU禁用AVX-512),直接调用不支持的指令会导致“非法指令”错误(如MSVS的“unhandled exception: illegal instruction”)。解决方案如下:
- 运行时检测:通过
cpuid内建函数检测CPU支持的AVX版本,在程序启动时初始化支持标志:
#include <intrin.h>
// 检测CPU是否支持AVX-512
bool is_avx512_supported() {
  int info[4];
  __cpuid(info, 7);  // CPUID功能码7:获取扩展功能信息
  // 检查AVX-512标志位(bit 16)
  return (info[1] & (1 << 16)) != 0;
}
- 多版本适配:针对不同AVX版本实现核心函数(如向量点积),运行时根据支持标志选择对应版本,避免性能损耗:
// AVX-2版本向量点积
float vecdot_avx2(float v1[8], float v2[8]) {
  __m256 reg1 = _mm256_loadu_ps(v1);
  __m256 reg2 = _mm256_loadu_ps(v2);
  __m256 dot = _mm256_dp_ps(reg1, reg2, 0xFF);  // 计算8元素点积
  return _mm256_cvtss_f32(dot);                 // 提取标量结果
}

// AVX-512版本向量点积
float vecdot_avx512(float v1[16], float v2[16]) {
  __m512 reg1 = _mm512_loadu_ps(v1);
  __m512 reg2 = _mm512_loadu_ps(v2);
  __m512 mul = _mm512_mul_ps(reg1, reg2);  // 元素级乘法
  return _mm512_reduce_add_ps(mul);        // 归约求和
}

// 统一调用接口:根据CPU支持动态选择版本
float vector_dot_product(float* v1, float* v2, int len) {
  if (is_avx512_supported() && len == 16) {
    return vecdot_avx512((float (*)[16])v1, (float (*)[16])v2);
  } else if (len == 8) {
    return vecdot_avx2((float (*)[8])v1, (float (*)[8])v2);
  } else {
    // fallback:串行计算
    float sum = 0.0f;
    for (int i = 0; i < len; i++) sum += v1[i] * v2[i];
    return sum;
  }
}
_mm256_zeroupper()
- 功能:清零YMM寄存器的上半部分
- 用途:在从AVX代码过渡到非AVX代码前调用,避免性能惩罚
-
使用场景:
-
程序部分组件用AVX编译,而其他部分不使用AVX
- 使用CPU分发(dispatching)技术编译多版本函数时
- AVX代码调用不支持AVX的外部库函数前
7. 典型应用示例:向量点积与元素级运算
AVX(128位)4元素向量点积
// 输入:两个4元素float数组,输出:点积结果(标量)
float aussie_avx_vecdot_4_floats(float v1[4], float v2[4]) {
  // 1. 加载数组到128位寄存器
  __m128 reg1 = _mm_loadu_ps(v1);
  __m128 reg2 = _mm_loadu_ps(v2);

  // 2.
  // 计算点积:_mm_dp_ps的第三个参数0xF1表示“所有元素参与点积,结果存储在低位”
  __m128 dot_result = _mm_dp_ps(reg1, reg2, 0xF1);

  // 3. 提取标量结果:_mm_cvtss_f32从128位寄存器提取低32位float
  return _mm_cvtss_f32(dot_result);
}
AVX-2(256位)8元素向量点积
_mm256_dp_ps默认仅处理4个元素,需通过“寄存器拆分+两次点积+求和”实现8元素点积:
float aussie_avx2_vecdot_8_floats(float v1[8], float v2[8]) {
  __m256 reg1 = _mm256_loadu_ps(v1);
  __m256 reg2 = _mm256_loadu_ps(v2);

  // 步骤1:计算8元素点积(拆分为两个4元素点积)
  // 0xFF:所有元素参与点积,结果存储在寄存器低128位
  __m256 dot = _mm256_dp_ps(reg1, reg2, 0xFF);

  // 步骤2:拆分256位寄存器为两个128位寄存器
  __m128 dot_low =
      _mm256_extractf128_ps(dot, 0);  // 低128位(含前4元素点积结果)
  __m128 dot_high =
      _mm256_extractf128_ps(dot, 1);  // 高128位(含后4元素点积结果)

  // 步骤3:求和两个128位寄存器的低32位(点积结果)
  __m128 sum = _mm_add_ss(dot_low, dot_high);

  // 步骤4:提取最终标量结果
  return _mm_cvtss_f32(sum);
}
总体示例:
/*
 * file: avx_showcase.cpp
 *
 * AVX 内建函数用法展示。
 * 覆盖算术、逻辑、数据重排等多种操作。
 */

#include <immintrin.h>  // AVX, AVX2, FMA 指令集头文件

#include <cstdlib>           // 跨平台内存对齐函数
#include <initializer_list>  // 用于打印向量
#include <iostream>
#include <vector>

// --- 辅助函数:分配32字节对齐内存 (AVX要求) ---
float* aligned_malloc(size_t size, size_t alignment) {
#if defined(_MSC_VER)
  return static_cast<float*>(_aligned_malloc(size, alignment));
#else
  void* ptr = nullptr;
  if (posix_memalign(&ptr, alignment, size) != 0) {
    return nullptr;
  }
  return static_cast<float*>(ptr);
#endif
}

// --- 辅助函数:释放对齐内存 ---
void aligned_free(void* ptr) {
#if defined(_MSC_VER)
  _aligned_free(ptr);
#else
  free(ptr);
#endif
}

// --- 辅助函数:打印 __m256 向量内容 ---
void print_vec(const char* title, __m256 vec) {
  float buffer[8];
  _mm256_storeu_ps(buffer, vec);
  std::cout << title << ": [";
  for (int i = 0; i < 8; ++i) {
    std::cout << buffer[i] << (i == 7 ? "" : ", ");
  }
  std::cout << "]" << std::endl;
}

// --- 示例1:向量加法 (Add) ---
// 计算 c = a + b
void vector_add(const float* a, const float* b, float* c, int n) {
  for (int i = 0; i < n; i += 8) {
    __m256 vec_a = _mm256_load_ps(&a[i]);
    __m256 vec_b = _mm256_load_ps(&b[i]);
    __m256 vec_c = _mm256_add_ps(vec_a, vec_b);
    _mm256_store_ps(&c[i], vec_c);
  }
}

// --- 示例2:融合乘加 (FMA) ---
// 计算 c = a * b + c
void vector_fma(const float* a, const float* b, float* c, int n) {
  for (int i = 0; i < n; i += 8) {
    __m256 vec_a = _mm256_load_ps(&a[i]);
    __m256 vec_b = _mm256_load_ps(&b[i]);
    __m256 vec_c = _mm256_load_ps(&c[i]);

    // FMA 指令: (a * b) + c
    vec_c = _mm256_fmadd_ps(vec_a, vec_b, vec_c);

    _mm256_store_ps(&c[i], vec_c);
  }
}

// --- 示例3:乘、减、绝对值 ---
// 计算 d = |a * b - c|
void vector_mul_sub_abs(const float* a, const float* b, const float* c,
                        float* d, int n) {
  // 用于清除符号位的掩码
  const __m256 abs_mask = _mm256_set1_ps(-0.0f);

  for (int i = 0; i < n; i += 8) {
    __m256 vec_a = _mm256_load_ps(&a[i]);
    __m256 vec_b = _mm256_load_ps(&b[i]);
    __m256 vec_c = _mm256_load_ps(&c[i]);

    __m256 mul_res = _mm256_mul_ps(vec_a, vec_b);
    __m256 sub_res = _mm256_sub_ps(mul_res, vec_c);
    __m256 abs_res = _mm256_andnot_ps(abs_mask, sub_res);  // 清除符号位得绝对值

    _mm256_store_ps(&d[i], abs_res);
  }
}

// --- 示例4:条件选择 / 最大值 ---
// c[i] = max(a[i], b[i])
void vector_max(const float* a, const float* b, float* c, int n) {
  for (int i = 0; i < n; i += 8) {
    __m256 vec_a = _mm256_load_ps(&a[i]);
    __m256 vec_b = _mm256_load_ps(&b[i]);

    // 直接使用 _mm256_max_ps 计算最大值
    __m256 vec_c = _mm256_max_ps(vec_a, vec_b);

    _mm256_store_ps(&c[i], vec_c);
  }
}

// --- 示例5:水平求和 (Horizontal Sum) ---
// 计算一个向量内8个浮点数的总和
float horizontal_sum(__m256 vec) {
  // [v7, v6, v5, v4, v3, v2, v1, v0]
  __m128 sum128 =
      _mm_add_ps(_mm256_extractf128_ps(vec, 1), _mm256_castps256_ps128(vec));
  __m128 sum_hadd1 = _mm_hadd_ps(sum128, sum128);
  __m128 sum_hadd2 = _mm_hadd_ps(sum_hadd1, sum_hadd1);
  return _mm_cvtss_f32(sum_hadd2);  // 提取最低位结果
}

// --- 示例6: 数学函数 ---
// 计算平方根和倒数平方根
void vector_math_functions(const float* a, float* b, float* c, int n) {
  for (int i = 0; i < n; i += 8) {
    __m256 vec_a = _mm256_load_ps(&a[i]);

    // 平方根
    __m256 sqrt_res = _mm256_sqrt_ps(vec_a);
    _mm256_store_ps(&b[i], sqrt_res);

    // 倒数平方根 (近似值)
    __m256 rsqrt_res = _mm256_rsqrt_ps(vec_a);
    _mm256_store_ps(&c[i], rsqrt_res);
  }
}

int main() {
  const int n = 16;  // 使用较小尺寸方便演示
  const size_t alignment = 32;

  float* a = aligned_malloc(n * sizeof(float), alignment);
  float* b = aligned_malloc(n * sizeof(float), alignment);
  float* c = aligned_malloc(n * sizeof(float), alignment);
  float* d = aligned_malloc(n * sizeof(float), alignment);

  for (int i = 0; i < n; ++i) {
    a[i] = static_cast<float>(i + 1);
    b[i] = static_cast<float>((i + 1) * 2);
    c[i] = static_cast<float>(i);
    d[i] = 0.0f;
  }

  std::cout << "--- AVX 内建函数演示 ---\n" << std::endl;

  // 1. 向量加法
  std::cout << "1. 向量加法 (c = a + b):" << std::endl;
  vector_add(a, b, c, n);
  std::cout << " c[0]=" << c[0] << " (预期: 3), c[1]=" << c[1] << " (预期: 6)"
            << std::endl;

  // 2. FMA
  // 重新初始化c以便FMA使用
  for (int i = 0; i < n; ++i) c[i] = static_cast<float>(i);
  std::cout << "\n2. 融合乘加 (c = a * b + c):" << std::endl;
  vector_fma(a, b, c, n);
  std::cout << " c[0]=" << c[0] << " (预期: 2), c[1]=" << c[1] << " (预期: 9)"
            << std::endl;

  // 3. 乘减绝对值
  for (int i = 0; i < n; ++i) c[i] = static_cast<float>(i * 3);  // 重置c
  std::cout << "\n3. 乘减绝对值 (d = |a * b - c|):" << std::endl;
  vector_mul_sub_abs(a, b, c, d, n);
  std::cout << " d[0]=" << d[0] << " (预期: 2), d[3]=" << d[3] << " (预期: 23)"
            << std::endl;

  // 4. 最大值
  std::cout << "\n4. 最大值 (c = max(a, b)):" << std::endl;
  vector_max(a, b, c, n);
  std::cout << " c[0]=" << c[0] << " (预期: 2), c[1]=" << c[1] << " (预期: 4)"
            << std::endl;

  // 5. 水平求和
  std::cout << "\n5. 水平求和:" << std::endl;
  __m256 test_vec = _mm256_set1_ps(1.0f);  // 8个1
  float sum = horizontal_sum(test_vec);
  std::cout << " sum of eight 1s = " << sum << " (预期: 8)" << std::endl;

  // 6. 数学函数
  std::cout << "\n6. 数学函数:" << std::endl;
  vector_math_functions(a, b, c, n);
  std::cout << " sqrt(a[3])=" << b[3] << " (预期: 2)" << std::endl;
  std::cout << " rsqrt(a[3])=" << c[3] << " (预期: ~0.5)" << std::endl;

  aligned_free(a);
  aligned_free(b);
  aligned_free(c);
  aligned_free(d);

  return 0;
}
这段代码一次循环处理8个浮点数,其性能远超标量版本。但代价是代码变得复杂且与AVX指令集绑定。
| 技术 | 接口/指令 | 编译器 | 优点 | 缺点 |
|---|---|---|---|---|
| 硬件预取 | (无, 自动) | 所有 | 对程序员透明 | 只能处理简单模式 |
| 软件预取 | __builtin_prefetch |
GCC, Clang | 灵活,处理复杂模式 | 增加编程复杂性,可能误导CPU |
_mm_prefetch |
Intel, GCC, Clang | 直接对应x86指令 | 同上 | |
#pragma prefetch |
Intel | 简单,循环级别控制 | 编译器特定 | |
| 自动向量化 | -O3 -march=native |
所有 | 对程序员透明 | 限制多,编译器可能过于保守 |
| 显式向量化 | #pragma omp simd |
GCC, Clang, Intel | 可移植性好,强制向量化 | 需要程序员保证安全性 |
#pragma ivdep |
GCC, Clang, Intel | 忽略依赖,更强力 | 风险高,可能导致错误结果 | |
| 内建函数 | _mm256_... , vaddq_f32 |
所有 | 终极性能和控制 | 复杂,不可移植,易出错 |
实践中最佳策略通常是:
- 编写简洁、对编译器友好的循环: 避免复杂控制流和指针别名,让自动向量化和硬件预取发挥最大作用。这是最基本也是最重要的一步。
- 使用分析工具: 利用编译器的优化报告 (
-fopt-info-vec) 和性能分析器 (Profiler) 来定位瓶颈。 - 辅助编译器: 当发现关键循环未能向量化或内存访问成为瓶颈时,首先尝试使用
#pragma omp simd或__builtin_prefetch来辅助编译器。 - 最终手段: 对于性能要求极致的核心代码段,才考虑使用内建函数进行手动重写。
SIMD向量化错误处理:NAN/INF传播
// 1. 向量化代码的NAN/INF传播
// SIMD友好的错误传播 (AVX2示例)
// 本函数计算向量的自然对数,同时优雅处理无效输入(如负数)
// 返回值中包含错误信息,且能自动传播到后续计算
__m256 safe_log(__m256 x) {
  // 1. 检查负数输入
  // _CMP_LT_OQ: 比较操作,返回一个掩码向量
  // 对每个元素:如果x[i] < 0.0,则对应掩码位为1(真),否则为0(假)
  __m256 mask = _mm256_cmp_ps(x, _mm256_setzero_ps(), _CMP_LT_OQ);

  // 2. 生成标准NAN载荷 (错误码=0xDEADBEEF)
  // 使用IEEE 754-2008规范,仅在尾数低22位存储错误码
  FloatPayload fp = encode_error(static_cast<ErrorCode>(0xDEADBEEF));
  __m256 nan_payload = _mm256_set1_ps(fp.f);

  // 3. 条件混合
  // _mm256_max_ps(x, FLT_MIN): 保护下溢,避免接近0的值产生-INF
  // _mm256_log_ps(...): 计算有效输入的对数
  // _mm256_blendv_ps(a, b, mask):
  // 条件混合指令,当mask对应位为1时选择b,否则选择a
  // 这里实现"向量化if-else":对负数输入使用NAN载荷,其他使用正常计算结果
  // 无分支(branchless)设计,避免了SIMD中的性能陷阱
  x = _mm256_blendv_ps(_mm256_log_ps(_mm256_max_ps(x, _mm256_set1_ps(FLT_MIN))),
                       nan_payload, mask);

  // 4. 自动传播至后续计算
  // 根据IEEE 754标准,NAN在任何算术运算中都会传播
  // 例如:NAN + 5 = NAN, log(NAN) = NAN, sqrt(NAN) = NAN
  // 这样错误会自动"感染"所有依赖此值的后续计算,无需中间检查
  return x;
}

// 仅在计算链末端调用,检查整个向量中是否存在任何错误(NAN/INF)
bool has_errors(__m256 result) {
  // 高效计算绝对值:通过位与操作清除符号位
  // -0.0f的位表示为0x80000000,_mm256_andnot_ps执行位非后与操作
  // 等效于:abs_result = |result|,但无需分支,纯位操作
  __m256 abs_result = _mm256_andnot_ps(_mm256_set1_ps(-0.0f), result);

  // 创建一个所有元素都是正无穷(INF)的向量
  __m256 inf = _mm256_set1_ps(INFINITY);

  // 检测INF和NAN:根据IEEE 754,NAN与任何值比较都返回false
  // 但NAN > INF 会返回true,所以使用>=可以同时捕获INF和NAN
  // _mm256_cmp_ps(..., _CMP_GE_OQ): 生成比较掩码,>=时为1
  // _mm256_movemask_ps: 将向量掩码转换为整数位掩码(低8位对应8个浮点元素)
  // 如果任何元素是INF或NAN,返回非零值,表示存在错误
  return _mm256_movemask_ps(_mm256_cmp_ps(abs_result, inf, _CMP_GE_OQ)) != 0;
}
使用向量类(Vector classes)
- 向量类提供更高层次的抽象,封装内建函数
- 优势:
- 操作符重载使代码更直观(使用+、*代替_add_ps等函数)
- 自动处理内存对齐
- 提供更丰富的功能和更好的类型安全
- 常用库:
- Agner Fog的vectorclass库:https://github.com/vectorclass
- Intel的Short Vector Math Library (SVML)
- 各种开源向量库
- 使用示例:
#include "vectorclass.h"
Vec8f a(array1);  // 8个单精度浮点数向量
Vec8f b(array2);
Vec8f c = a + b;  // 直观的向量加法
c.store(result);  // 存储结果
- 高级特性:
- 混合精度计算
- 条件执行(掩码操作)
- 水平操作(reduction)
- 与标量代码的无缝集成