9.1 Roofline模型
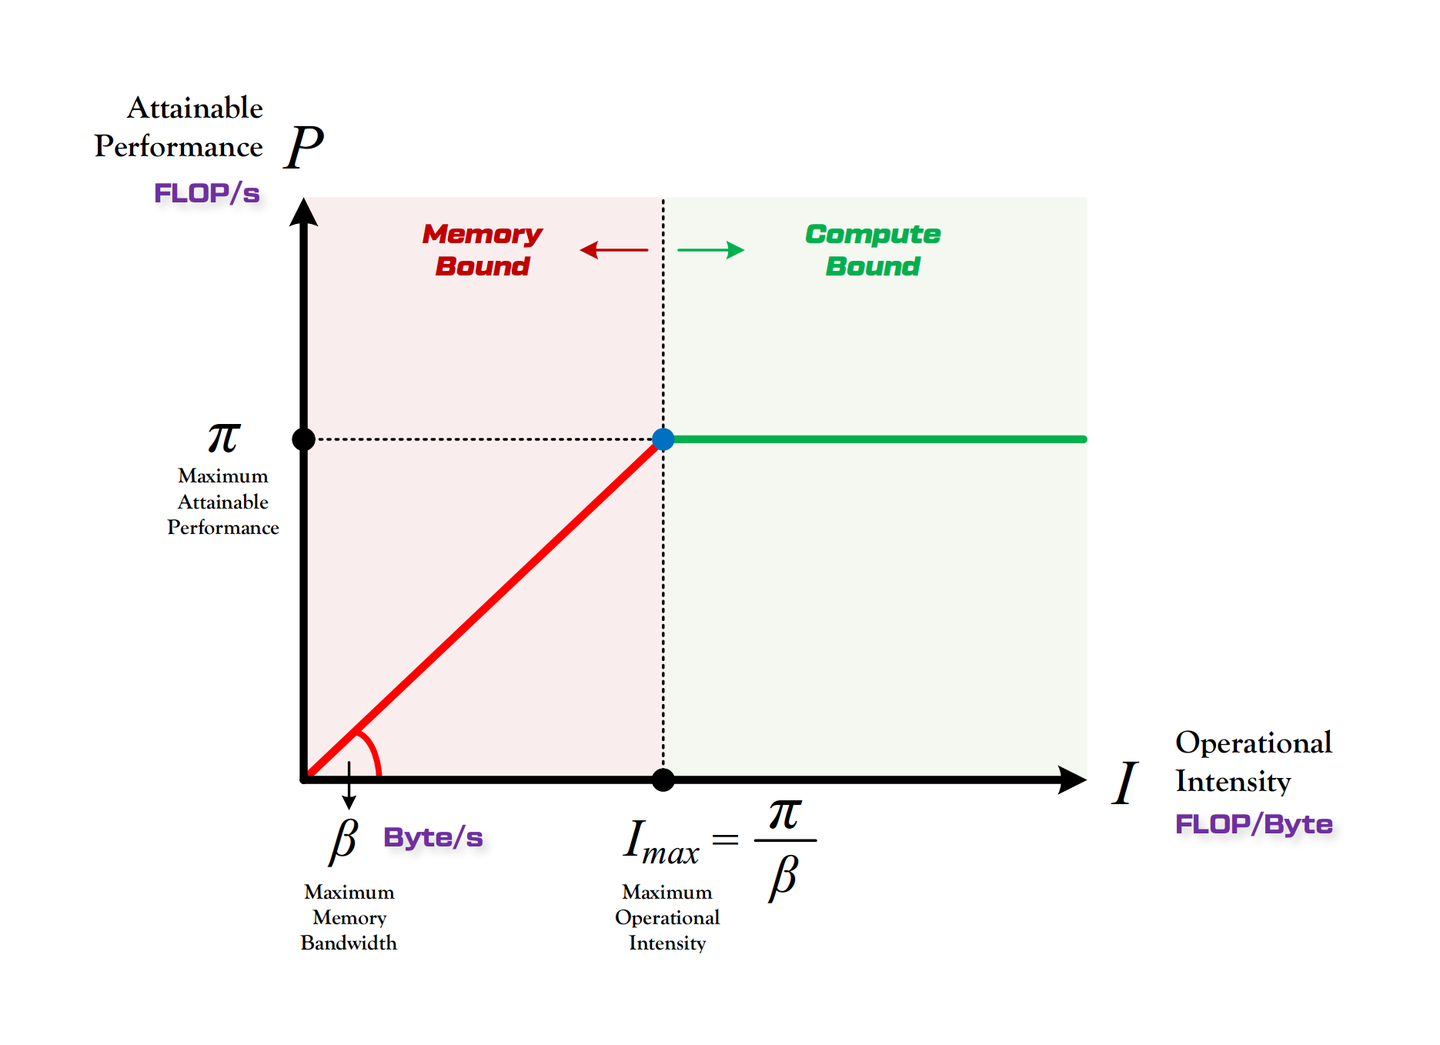
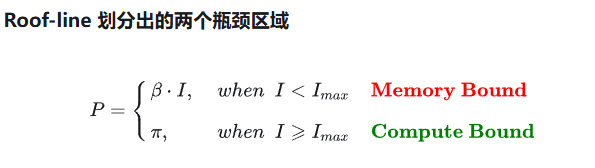
- 计算平台的两个指标:算力和带宽。
- 模型的两个指标:计算量和访存量。
- 使用 Roof-line Model 分析模型在计算平台上所能达到的理论计算性能,并分析模型在计算平台上的两种互斥状态:计算受限状态和带宽受限状态。
- 如果数据点位于屋顶线的倾斜部分,则性能可能受内存带宽的限制(内存绑定)。提高操作强度(每访问一个字节的数据执行更多计算)可能会提升性能。
- 如果数据点位于天花板的平坦部分,则性能可能受计算能力(计算受限)的限制。在这种情况下,除非能够更好地利用硬件的峰值 FLOPS,否则进一步提高运维强度可能不会带来显著的性能提升。
- 数据点与天花板的距离表示性能提升的潜力。距离越大,就表示有机会优化程序,以更好地利用硬件的功能。
Roofline 模型讲的是程序在计算平台的算力和带宽这两个指标限制下,所能达到的理论性能上界,而不是实际达到的性能,因为实际计算过程中还有除算力和带宽之外的其他重要因素,它们也会影响模型的实际性能,这是 Roofline Model 未考虑到的。
对于 Intel Core i5-8259U 处理器,使用 AVX2 和 2 个 Fused Multiply Add (FMA) 单元的最大 FLOP 数(单精度浮点)可以计算如下:
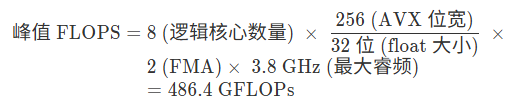
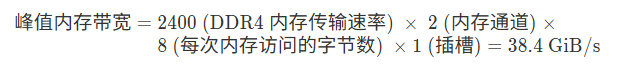
对于 Intel NUC Kit NUC8i5BEH 的最大内存带宽可以如下计算。DDR 技术允许每次内存访问传输 64 位或 8 个字节。
Memory Bound优化
- 缓存友好数据结构: 设计数据结构时,考虑如何最大化利用缓存的局部性原理。
- 顺序访问: 利用硬件预取器,按数据在内存中的顺序访问,提升空间局部性。
- 数据压缩/紧凑: 减少数据大小,提高缓存利用率和内存带宽效率。
- 对齐与填充: 确保数据结构成员在内存中适当对齐,避免跨缓存行访问。
- 显式内存预取: 在数据被需要之前,通过软件指令(如
__builtin_prefetch)提示 CPU 将数据加载到缓存中,以隐藏内存访问延迟。在数据库中,这可以用于预读数据页。 - 大页 (Huge Pages): 使用 2MB 或 1GB 的大页面而不是默认 4KB 页面,可以显著减少 TLB 未命中次数,降低地址转换开销。
Core Bound优化
- 概念: 当应用程序的性能瓶颈主要在于 CPU 的计算能力,而非内存访问时,我们称之为Core Bound。这通常通过 TMA 方法论中的“Core Bound”类别指标来体现。
- 两种主要情况:
- 数据流依赖限制(低 ILP): 指令之间存在较长的数据依赖链,导致 CPU 的乱序执行引擎无法充分发挥并行处理能力。例如,链表遍历就是典型的长依赖链,CPU 必须按顺序等待前一个指针解引用后才能处理下一个。这种情况下,即使 CPU 有大量空闲执行单元,也因等待依赖数据而停滞,导致指令级并行性 (ILP) 较低。
- 硬件计算资源短缺(执行端口竞争): 某些特定的执行单元(如乘法器、除法器、浮点单元)过载。当工作负载频繁执行大量相同类型的复杂指令时,CPU 的特定执行端口可能会饱和,指令不得不排队等待执行。这通常与 CPU 微架构的执行单元数量和吞吐量限制有关。
- 优化方向: Core Bound优化旨在减少 CPU 需要完成的总工作量,或通过更高效的指令序列来完成工作。
- 函数内联(Function Inlining): 将小函数的代码直接插入到调用点,消除函数调用(
CALL/RET指令)的开销(如保存/恢复寄存器),并扩大编译器优化范围,使其能更好地进行跨函数优化。循环优化: 循环通常是程序执行时间最集中的区域。 - 循环不变代码外提(将循环内不变的计算移到循环外)、循环展开(减少循环控制开销)、循环交换(改变嵌套循环顺序以改善内存局部性)、循环阻塞/平铺(将大循环数据分解为小块以适应缓存)。
-
向量化(Vectorization):
-
利用 CPU 的 SIMD (Single Instruction, Multiple Data) 指令集。SIMD 指令允许一个指令在单个周期内同时操作多个数据元素。
- 自动向量化: 编译器会自动识别并转换代码以使用 SIMD 指令。
- 显式向量化: 当编译器无法自动向量化或向量化不理想时,使用编译器内置函数(intrinsics)或专门的库(如 Google Highway)手动编写 SIMD 代码,实现更精细的控制和更高性能。