3.1 函数传参优化
1. 临时对象
表达式求值中临时创建的无名对象,默认生命周期在所在完整表达式结束时结束。
- 函数返回非引用类型的对象(如
return T())。 - 类型转换(如
int转double、自定义类型构造转换)。 - 表达式中间结果(如
a + b的返回值)。 - 字面量或匿名对象(如
"abc"、T())。 - 按值传递的函数参数(实参到形参的拷贝过程)。
生命周期延长:被const T&或T&&绑定后,生命周期与引用一致。
2. const T& 的作用
安全地“借用”对象,避免拷贝开销,同时保证只读性。
- 可绑定左值和右值。
- 延长所绑定右值的生命周期,允许安全访问但不可修改。
3. T&& 的作用
突破 const T& 的局限,实现对临时对象资源的“接管”而非“借用”。
移动语义:通过移动构造/赋值运算符接管右值的资源,避免深拷贝和资源重复释放。
支持修改临时对象:无const限制,可直接修改绑定的右值,修改后的数据可被复用。
完美转发:结合std::forward和引用折叠,在模板中保持参数的左值/右值属性,确保正确调用拷贝或移动语义的重载函数。
明确语义:专门绑定右值(或std::move标记的左值),清晰表达“资源可被安全转移”的语义。
4. 关联与对比
| 特性 | const T& (只读借用者) |
T&& (资源继承者) |
|---|---|---|
| 权限 | 只读 (Read-Only) | 可修改 (Writable) |
| 核心目的 | 避免传值拷贝的开销 | 通过移动语义,彻底消除深拷贝 |
| 资源归属 | 资源所有权不变 | 资源所有权发生转移 |
| 处理对象 | 可以绑定所有对象(左值、右值) | 只能绑定右值(临时对象或std::move的对象) |
| 典型场景 | 函数参数,以只读方式高效访问对象 | 移动构造/赋值,完美转发(std::forward) |
| 解决的问题 | C++98高效传递对象的方式 | C++11解决临时对象深拷贝 |
5. C++拷贝构造函数等函数对传参的影响-非零成本抽象
struct A {
  int data{1};
};
void foo(A a);
int main() {
  A a;
  foo(a);
}
// 未定义拷贝构造函数的结构体A,参数通过寄存器传递,汇编:mov edi, 1 → call
// foo(A),无栈操作。
struct A {
  A() = default;
  A(const A& rhs) : data(rhs.data) {}
  int data{1};
};
void foo(A a);
int main() {
  A a;
  foo(a);
}
// 添加自定义拷贝构造函数后,参数转为栈上临时对象传递,
// 汇编:分配栈空间(sub rsp, 24),复制临时对象(lea rdi,
// [rsp+12]),再传递地址。
Itanium C++ ABI规则:
参数类型若为“非平凡类类型”,调用者需在栈上分配临时对象,并传递其地址。
非平凡类类型的定义:
拥有非平凡的拷贝/移动构造函数或析构函数;
或所有拷贝/移动构造函数被删除(=delete)。
平凡类型(Trivial Type):
具备平凡构造函数、拷贝/移动构造函数、析构函数(编译期默认生成、=default);
是POD类型的子集,支持位拷贝和跨语言兼容。
结论:
自定义拷贝构造函数(即使逻辑等价)会使类型变为非平凡,触发栈上传递;
原本可通过寄存器传递的小对象(如int)被强制改为栈操作,增加内存访问开销。
若无需自定义拷贝/移动逻辑或析构行为,依赖编译器生成的默认版本;
6. 使用 string_view 避免复制
std::string_view包含一个指向不可变字符串缓冲区开头的指针和一个大小。由于字符串是一系列连续的字符,指针和大小完全定义了一个有效的子字符串范围。通常,std::string_view指向由std::string拥有的一些内存。但它也可以指向具有静态存储期的字符串字面量或类似内存映射文件的东西。以下图表显示了std::string_view指向由std::string拥有的内存:
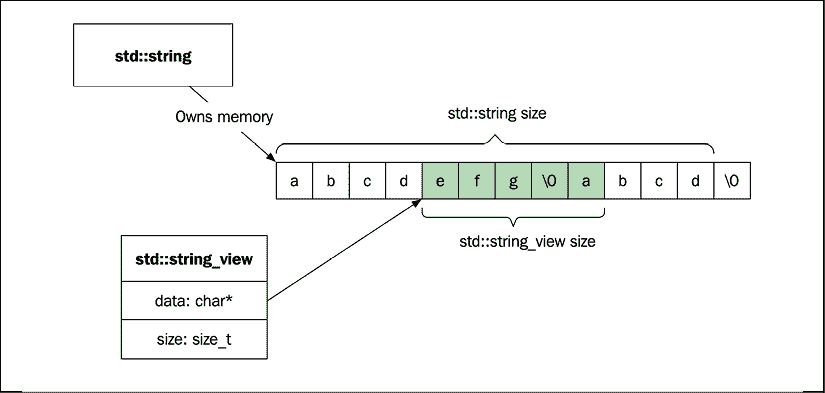
由std::string_view定义的字符序列不需要以空字符结尾,但包含空字符的字符序列是完全有效的。另一方面,std::string需要能够从c_str()返回以空字符结尾的字符串,这意味着它总是在序列的末尾存储额外的空字符。
string_view不需要空终止符的事实意味着它可以比 C 风格字符串或std::string更有效地处理子字符串,因为它不必创建新的字符串来添加空终止符。
将字符串传递给函数时也会有性能提升。
auto some_func(const std::string& s) {
  // process s ...
}
some_func("A string literal");  // Creates a std::string
当将字符串字面量传递给some_func()时,编译器需要构造新的std::string对象以匹配参数的类型。如果我们让some_func()接受一个std::string_view,就不需要构造std::string了:
auto some_func(std::string_view s) {  // Pass by value
                                      // process s ...
}
some_func("A string literal");
7. 使用 std::span 消除数组衰减
数组衰减(失去数组的大小信息)在将内置数组传递给函数时会发生:
// buffer looks like an array, but is in fact a pointer
auto f1(float buffer[]) {
  const auto n = std::size(buffer);  // Does not compile!
  for (auto i = 0u; i < n; ++i) {    // Size is lost!
    // ...
  }
}
使用内置数组的数组衰减是许多与边界相关的错误的根源,除了与std::string_view相似的作用,std::span提供了一种更安全的方法将数组传递给函数。由于 span 在一个对象中同时保存了指向内存的指针和大小,因此我们可以将其用作将元素序列传递给函数时的单一类型:
auto f3(std::span<float> buffer) {  // Pass by value
  for (auto&& b : buffer) {         // Range-based for-loop
    // ...
  }
}
float a[256];
f3(a);  // OK! Array is passed as a span with size
auto v = std::vector{1.f, 2.f, 3.f, 4.f};
f3(v);  // OK!
与内置数组相比,span 更方便使用,因为它更像一个具有迭代器支持的常规容器。
在数据成员(指针和大小)和成员函数方面,std::string_view和std::span之间很相似。但也有区别:std::span指向的内存是可变的,而std::string_view总是指向常量内存。std::string_view还包含特定于字符串的函数,如hash()和substr()。最后,在std::span中没有compare()函数,因此不可能直接在std::span对象上使用比较运算符。