9.4 性能衡量要点
关键延迟指标
-
基础延迟定义
-
Tick-to-Trade(TTT):从行情数据到达参与者系统到订单发出的时间(包含行情解析、策略计算、订单生成等环节),是高频交易核心指标。
- Round-Trip Time(RTT):订单从发送到交易所、处理并返回确认的往返时间,包含网络传输、匹配引擎处理、响应返回等耗时。
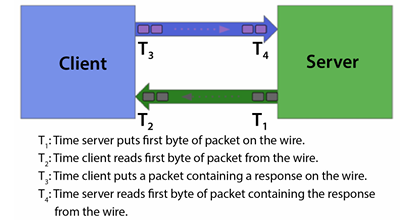
- Time to First Byte:数据从发送方到接收方首字节的传输时间,常用于衡量网络传输效率。
-
统计性延迟指标
-
平均延迟:所有操作的平均耗时,反映整体性能水平,易受极端值干扰,实际场景更看重延迟的确定性。
- 中位数延迟(P50):更能反映典型场景的延迟表现,排除 outliers 影响。
- 尾延迟(P99/P999):99%/99.9%的操作能完成的最大延迟,对稳定性要求极高的系统(如做市商系统)至关重要,需控制在微秒级甚至纳秒级。
- 延迟方差:衡量延迟波动程度,低方差意味着系统表现更稳定,避免因延迟抖动导致策略失效。
常见时延表
| Operation | cpu cycle | 中文解释 |
|---|---|---|
| Add, Sub, And, Or | < 1 | 加法、减法、与、或操作 |
| memory write | ≈ 1 | 内存写操作 |
| "right" branch of "if" | ≈ 1 | "if"语句的“正确”分支 |
| Mul | 3 - 6 | 乘法操作 |
| L1 read | 4 | L1缓存读取 |
| L2 read | 10 - 12 | L2缓存读取 |
| "wrong" branch of "if" | 10 - 20 | "if"语句的“错误”分支 |
| L3 read | 30 - 50 | L3缓存读取 |
| Div | 20 - 100 | 除法操作 |
| Function call | 20 - 30 | 函数调用 |
| Addition polymorphic function call | 25 - 250 | 多态函数调用 |
| Mutex lock/unlock | 50+ | 互斥锁的锁定/解锁 |
| Main RAM read | 100 - 150 | 主内存读取 |
| NUMA: different socket L3 read | 100 - 200 | NUMA架构下不同插槽的L3缓存读取 |
| NUMA: different socket RAM read | 200 - 300 | NUMA架构下不同插槽的主内存读取 |
| Allocation deallocation pair | 200+ | 分配和释放操作对 |
| User to kernel switch and back | 300 - 500 | 用户态到内核态的切换及返回 |
| Exception throw + caught | 1000 - 2000 | 异常抛出并捕获 |
| Context switch (direct cost) | 2000 | 上下文切换(直接成本) |
| Context switch (total costs, including cache invalidation) | 10K - 1M | 上下文切换(总成本,包括缓存失效) |
| Disk read | 400K+ | 磁盘读取 |
性能测量工具与方法
-
高精度时间追踪
-
使用
rdtsc/rdtscp指令(CPU周期计数器)测量纳秒级耗时,记录关键环节(如订单生成、匹配引擎处理)的起始与结束时间戳。 - 结合
std::chrono::high_resolution_clock等工具,实现跨平台的高精度时间测量。 -
PTP (精确时间协议) 通过硬件时间戳,在局域网内实现微秒至亚微秒级高精度时钟同步的金融行业标准
-
系统级性能剖析
调试与性能分析工具:https://www.yuque.com/bluememories/lanaff/sxleuxuom18gotls
perf深入剖析参考:https://xie.infoq.cn/article/d86b3a3ca106449cb3f369a0f
perf工具:采样CPU周期、缓存未命中率、分支预测失败率等,定位热点函数(如通过perf record -g分析调用栈)。numastat:监控NUMA架构下的本地/远程内存访问比例,远程访问占比需控制在10%以下以避免性能损耗。valgrind:检测内存访问局部性问题,优化数据布局以提升缓存命中率。-
Intel VTune:分析指令流水线停顿、缓存失效等硬件级瓶颈。
-
组件级延迟测量
追踪组件内部延迟
(1)交易所端测量对象及功能说明
| 函数名 | 功能说明 |
|---|---|
| Common::McastSocket::send() | 多播套接字(McastSocket)的发送方法,用于通过多播协议向市场参与者分发市场数据(如订单簿更新、成交信息等)。 |
| Exchange::MEOrderBook::add() | 订单簿(MEOrderBook)的添加方法,用于将新订单添加到交易所的订单簿中,维护订单簿的状态。 |
| Exchange::MEOrderBook::cancel() | 订单簿的取消方法,用于处理客户端的订单取消请求,从订单簿中移除指定订单。 |
| Exchange::MatchingEngine::processClientRequest() | 撮合引擎(MatchingEngine)的核心方法,负责接收并处理客户端的各类请求(如新建订单、取消订单等),是请求处理的入口。 |
| Exchange::MEOrderBook::removeOrder() | 订单簿的订单移除方法,具体执行从订单簿中删除指定订单的操作,确保订单簿数据准确。 |
| Exchange::MEOrderBook::match() | 订单簿的撮合方法,核心功能是寻找订单簿中可匹配的买卖订单(如买单与卖单价格交叉时),执行成交逻辑,是交易系统的核心环节。 |
| Exchange::MEOrderBook::checkForMatch() | 订单簿的匹配检查方法,在新订单添加或订单状态变化时,检查是否存在可撮合的订单,为后续的match()方法触发提供依据。 |
| Exchange::MEOrderBook::addOrder() | 订单簿的订单添加具体实现方法,负责将订单按规则(如价格、时间优先级)插入订单簿的对应位置,维护订单簿的有序性。 |
| Common::TCPSocket::send() | TCP套接字的发送方法,用于通过TCP协议向客户端发送响应信息(如订单确认、取消结果等),保证数据可靠传输。 |
| Exchange::FIFOSequencer::addClientRequest() | FIFO序列器(FIFOSequencer)的请求添加方法,将客户端请求按接收顺序加入序列器,确保请求按先后顺序处理,避免乱序。 |
| Exchange::FIFOSequencer::sequenceAndPublish() | FIFO序列器的排序与发布方法,对已加入的请求进行排序(按FIFO规则),并将排序后的事件发布到后续处理组件(撮合引擎)。 |
(2)市场参与者测量对象及功能说明
| 函数名 | 功能说明 |
|---|---|
| Trading::MarketDataConsumer::recvCallback() | 市场数据消费者(MarketDataConsumer)的接收回调方法,当从交易所接收到市场数据(如订单簿更新、成交信息)时触发,用于处理和解析市场数据。 |
| Common::TCPSocket::send() | TCP套接字的发送方法,用于客户端向交易所发送订单请求(如新建订单、取消订单等),通过TCP协议保证请求的可靠传输。 |
| Trading::OrderGateway::recvCallback() | 订单网关(OrderGateway)的接收回调方法,当从交易所接收到响应信息(如订单状态更新、成交回报)时触发,用于处理和分发这些响应。 |
| Trading::OrderManager::moveOrders() | 订单管理器(OrderManager)的批量订单调整方法,用于批量调整已有订单的参数(如价格、数量),适用于策略需要批量修改订单的场景。 |
| Trading::OrderManager::onOrderUpdate() | 订单管理器的订单更新处理方法,当接收到交易所的订单状态更新(如订单部分成交、完全成交、被拒绝)时触发,用于更新本地订单状态并同步给相关组件。 |
| Trading::MarketOrderBook::addOrder() | 客户端市场订单簿(MarketOrderBook)的订单添加方法,用于将从交易所接收的订单信息添加到本地维护的订单簿中,同步交易所订单簿状态。 |
| Trading::MarketOrderBook::removeOrder() | 客户端市场订单簿的订单移除方法,当交易所订单被取消或成交时,从本地订单簿中移除对应订单,保持本地订单簿与交易所一致。 |
| Trading::MarketOrderBook::updateBBO() | 客户端市场订单簿的最佳买卖报价(BBO)更新方法,用于根据最新的订单簿状态更新最佳买价、最佳卖价及对应的数量,为交易策略提供关键价格参考。 |
| Trading::OrderManager::cancelOrder() | 订单管理器的订单取消方法,用于向交易所发送指定订单的取消请求,并处理取消过程中的状态跟踪。 |
| Trading::RiskManager::checkPreTradeRisk() | 风险管理器(RiskManager)的交易前风险检查方法,在发送新订单前检查是否符合风险规则(资金限额、持仓限制、价格波动限制等),控制交易风险。 |
| Trading::OrderManager::newOrder() | 订单管理器的新订单创建方法,用于生成新订单请求(包含价格、数量、方向等参数),并通过订单网关发送给交易所。 |
| Trading::OrderManager::moveOrder() | 订单管理器的单个订单调整方法,用于修改单个已有订单的参数(如价格、数量),适用于策略对特定订单的精细化调整。 |
| Trading::PositionKeeper::updateBBO() | 持仓管理器(PositionKeeper)的BBO更新方法,根据最新的最佳买卖报价更新持仓相关的风险计算或估值模型,辅助风险控制和策略决策。 |
| Trading::FeatureEngine::onOrderBookUpdate() | 特征引擎(FeatureEngine)的订单簿更新处理方法,在订单簿发生变化时提取特征数据(如订单簿深度变化、价差变化等),为交易算法提供输入特征。 |
| Trading::TradeEngine::algoOnOrderBookUpdate() | 交易引擎(TradeEngine)的订单簿更新算法触发方法,当订单簿更新时执行预设的交易算法逻辑(如套利策略、做市策略),生成交易决策。 |
| Trading::FeatureEngine::onTradeUpdate() | 特征引擎的成交更新处理方法,在发生新成交时提取成交相关特征(如成交量、成交价格分布等),为交易算法提供市场流动性等特征信息。 |
| Trading::TradeEngine::algoOnTradeUpdate() | 交易引擎的成交更新算法触发方法,当接收到成交信息时执行对应的交易算法逻辑(如根据成交量变化调整策略参数)。 |
| Trading::PositionKeeper::addFill() | 持仓管理器的成交记录添加方法,在订单成交后记录成交信息(如成交价格、数量、方向),并更新账户的持仓数量和成本。 |
| Trading::TradeEngine::algoOnOrderUpdate() | 交易引擎的订单更新算法触发方法,当自身订单状态发生更新(如部分成交、被取消)时执行对应的算法逻辑(如根据订单执行情况调整后续策略)。 |
追踪组件间传播过程延迟
(1)交易所端时间戳事件
| 时间戳标识 | 事件描述 |
|---|---|
| T1_OrderServer_TCP_read | 订单服务器(OrderServer)中,通过 TCP 套接字首次读取客户请求的时间 |
| T2_OrderServer_LFQueue_write | 订单服务器将客户请求写入 “连接撮合引擎(MatchingEngine)的无锁队列(LFQueue)” 的时间 |
| T3_MatchingEngine_LFQueue_read | 撮合引擎从 “连接自身的无锁队列(LFQueue)” 中读取客户请求的时间 |
| T4_MatchingEngine_LFQueue_write | 撮合引擎将市场更新写入 “连接市场数据发布器(MarketDataPublisher)的无锁队列(LFQueue)” 的时间 |
| T4t_MatchingEngine_LFQueue_write | 撮合引擎将客户响应写入 “连接订单服务器的无锁队列(LFQueue)” 的时间 |
| T5_MarketDataPublisher_LFQueue_read | 市场数据发布器从 “连接自身的无锁队列(LFQueue)” 中读取市场更新的时间 |
| T5t_OrderServer_LFQueue_read | 订单服务器从 “连接自身的无锁队列(LFQueue)” 中读取客户响应的时间 |
| T6_MarketDataPublisher_UDP_write | 市场数据发布器将市场更新写入 UDP 套接字的时间 |
| T6t_OrderServer_TCP_write | 订单服务器将客户响应写入 TCP 套接字的时间 |
(2)市场参与者端时间戳事件
| 时间戳标识 | 事件描述 |
|---|---|
| T7_MarketDataConsumer_UDP_read | 市场数据消费者(MarketDataConsumer)从 UDP 套接字读取市场数据更新的时间 |
| T7t_OrderGateway_TCP_read | 订单网关(OrderGateway)从 TCP 套接字读取客户响应的时间 |
| T8_MarketDataConsumer_LFQueue_write | 市场数据消费者将市场数据更新写入 “连接交易引擎(TradeEngine)的无锁队列(LFQueue)” 的时间 |
| T8t_OrderGateway_LFQueue_write | 订单网关将客户响应写入 “连接交易引擎的无锁队列(LFQueue)” 的时间 |
| T9_TradeEngine_LFQueue_read | 交易引擎从 “连接市场数据消费者的无锁队列(LFQueue)” 中读取市场数据更新的时间 |
| T9t_TradeEngine_LFQueue_read | 交易引擎从 “连接订单网关的无锁队列(LFQueue)” 中读取客户响应的时间 |
| T10_TradeEngine_LFQueue_write | 交易引擎将客户请求写入 “连接订单网关的无锁队列(LFQueue)” 的时间 |
| T11_OrderGateway_LFQueue_read | 订单网关从 “连接交易引擎的无锁队列(LFQueue)” 中读取客户请求的时间 |
| T12_OrderGateway_TCP_write | 订单网关将客户请求写入 TCP 套接字的时间 |
Tick-to-Trade
| 阶段 | 函数名 | 功能说明 |
|---|---|---|
| 起点:接收市场数据(tick进入系统) | Trading::MarketDataConsumer::recvCallback() |
市场数据消费者从UDP套接字接收交易所推送的市场数据更新(如订单簿变化、成交信息等),是“tick”进入客户端系统的第一个处理点 |
| 中间关键处理函数(决策链路) | Trading::MarketOrderBook::addOrder() / Trading::MarketOrderBook::removeOrder() / Trading::MarketOrderBook::updateBBO() |
将接收的市场数据更新到本地维护的订单簿,计算最佳买卖报价(BBO),为策略提供基础市场状态 |
| 中间关键处理函数(决策链路) | Trading::FeatureEngine::onOrderBookUpdate() |
从更新后的订单簿中提取特征(如订单簿深度、价差变化等),为交易算法提供输入 |
| 中间关键处理函数(决策链路) | Trading::TradeEngine::algoOnOrderBookUpdate() |
交易引擎根据特征数据执行交易算法逻辑(如做市策略、吃单策略),生成交易决策(如新建订单、调整订单) |
| 中间关键处理函数(决策链路) | Trading::OrderManager::newOrder()(或 moveOrder() / cancelOrder(),根据决策类型) |
订单管理器根据交易引擎的决策,生成具体的订单请求(包含价格、数量等参数) |
| 中间关键处理函数(决策链路) | Trading::RiskManager::checkPreTradeRisk() |
对生成的订单进行交易前风险检查(如资金、持仓限制),确保合规 |
| 终点:发送交易订单(trade发出系统) | Common::TCPSocket::send()(市场参与者客户端的TCP发送函数) |
经过风险检查后,订单网关通过TCP套接字将订单请求发送给交易所,完成“trade”的发出 |